 Gonzalo Gomez
Equipo de agentes en Claude Code: tech lead, devs y QA
Cómo armé un equipo de agentes en Claude Code: un tech lead que dimensiona el trabajo, devs con briefs en disco, un QA de solo lectura y cuánto costó una tarea.
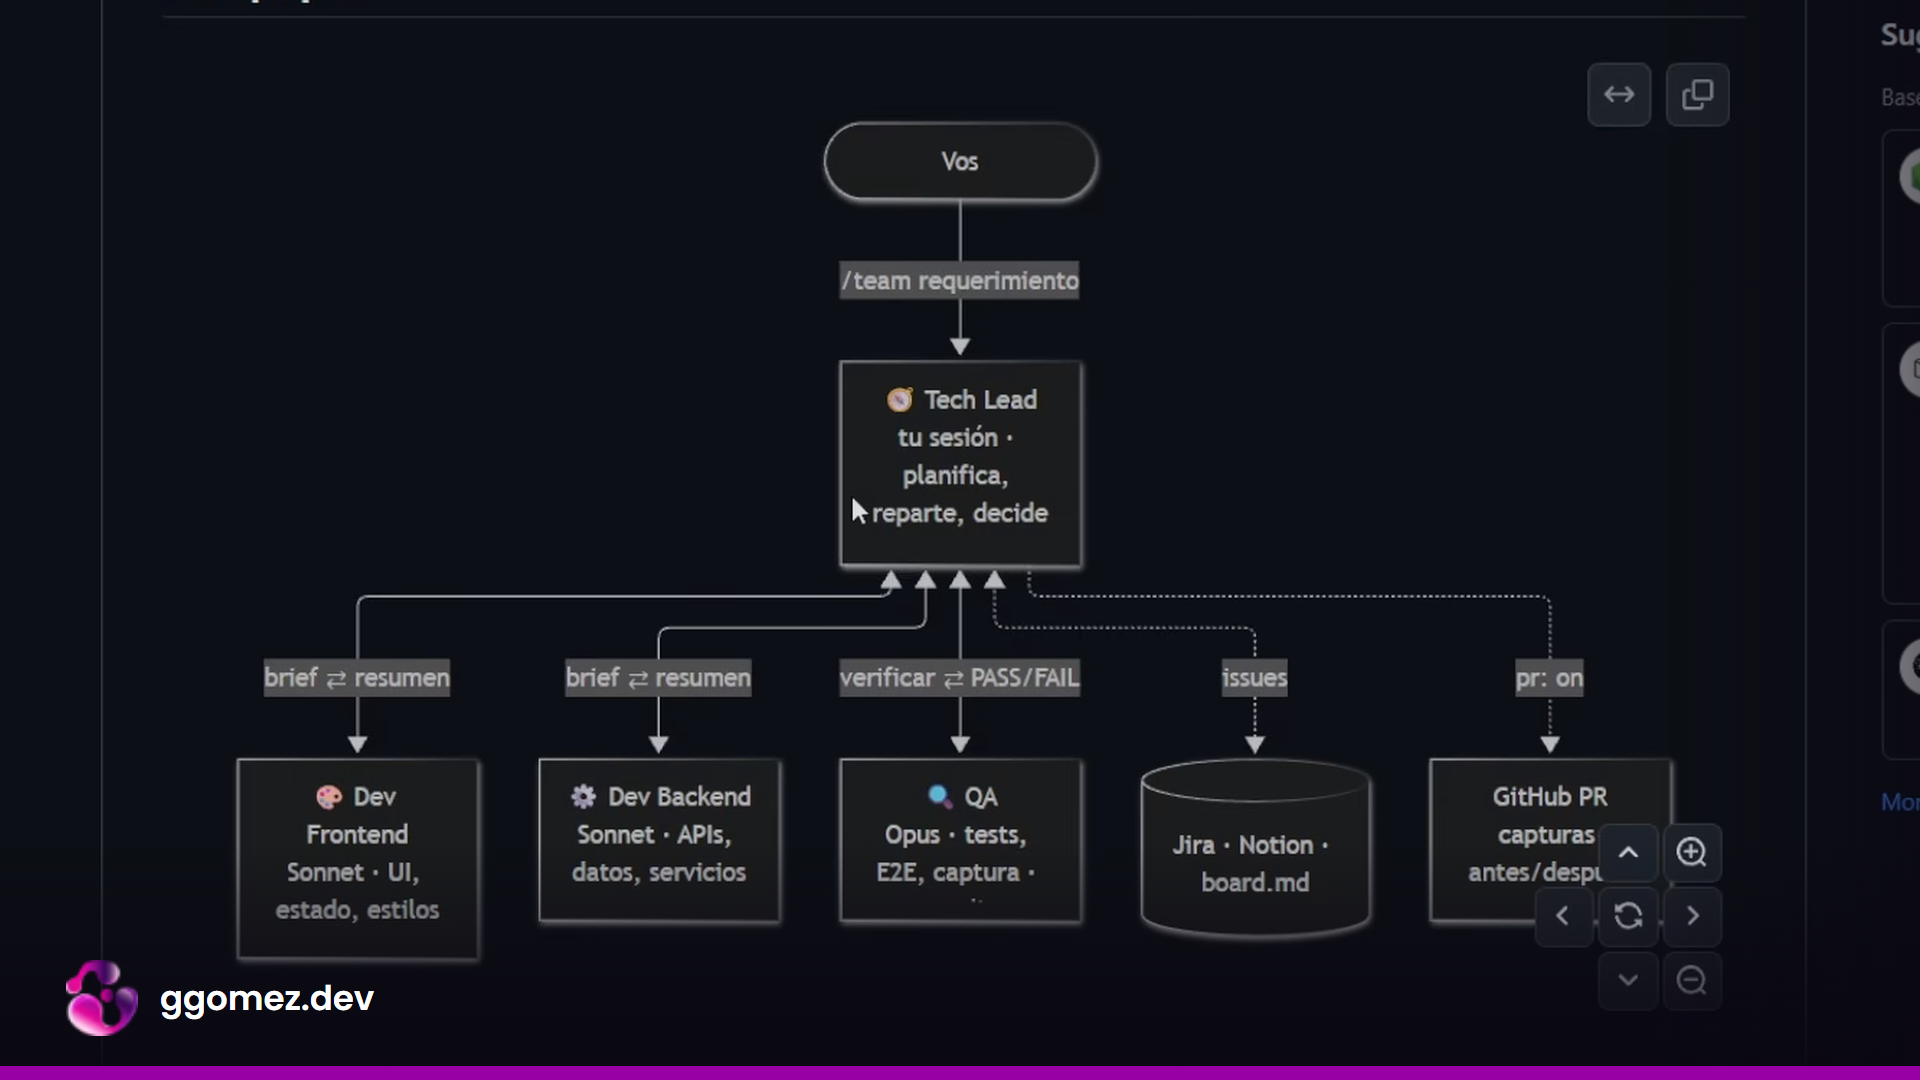
Claude Code ya escribe código más rápido de lo que yo llego a verificarlo. La parte lenta de mi día hace rato que dejó de ser la implementación. Era yo, abriendo un navegador, recorriendo los casos, encontrando el borde que se rompía y escribiéndole de vuelta a Claude. Así que armé un plugin que pasa cada requerimiento por la misma estructura que usaba como tech lead. Alguien que dimensiona y divide el trabajo, developers que ejecutan un brief cerrado y un QA que prueba que funciona antes de darlo por terminado.
Este post cuenta cómo está armado, cuánto me costó en una tarea real y dónde se rompe. El plugin es open source (MIT) y está en GonzaGomezDev/claude-software-agents.
El problema con el loop por defecto
El loop habitual de Claude Code es este: describís una feature, Claude planifica, aprobás, Claude edita, lo probás a mano, contás qué falló y das otra vuelta. Generar es barato. Verificar es serial y pasa por una sola persona. En un proyecto con UI, esa persona se pasa la mayor parte de la sesión en un navegador.
En un equipo profesional ese loop se reparte entre roles. Un tech lead convierte el requerimiento del cliente en tareas chicas y testeables. Los developers las implementan. QA las controla contra los criterios que escribió el tech lead. Nadie se corrige su propia tarea. Yo quería esa misma separación dentro de una sola sesión de Claude Code, sin pagar cuatro sesiones completas para tenerla.
El equipo
- Tech Lead: tu sesión principal. Lee la config, dimensiona el requerimiento, escribe el plan y los briefs, despacha al resto y decide.
- Dev Frontend: UI, estado del cliente, estilos, tests del lado del cliente.
- Dev Backend: APIs, datos, servicios, tests del lado del servidor.
- QA: verificación independiente. Corre tests, lint, build y E2E, saca una captura de la UI y reporta PASS o FAIL con evidencia. No puede editar código.
Los devs y QA no tienen la tool Agent, así que el tech lead es el centro por diseño. Los devs nunca hablan entre sí; el tech lead les lleva el contrato de la API de uno a otro.
La línea más importante de todo el plugin es la lista de tools del agente de QA:
---
name: qa
description: QA engineer of the software-team. Independently verifies task briefs
  against their acceptance criteria and reports PASS/FAIL with evidence. Read-only on code.
model: opus
effort: medium
tools: Read, Grep, Glob, Bash
---
Sin Edit y sin Write. Bash está para correr chequeos y sacar capturas, y el prompt le prohíbe tocar archivos del proyecto fuera de .team/qa/. Un revisor que puede parchear el código termina aprobando sus propios parches. Sacarle el permiso es más barato y más confiable que pedirle amablemente que sea estricto.
Cómo se instala
Dos comandos dentro de una sesión de Claude Code:
/plugin marketplace add GonzaGomezDev/claude-software-agents
/plugin install software-team@software-team
La instalación te pide un alcance: solo para vos, para todos los colaboradores del repo o local a este repositorio. Después corrés el setup una vez por proyecto:
/team setup                      # writes .team/config.md
/team agregar filtro por fecha   # runs a requirement through the team
/team on                         # every code request goes through the Tech Lead
/team off
/team on y /team off los maneja un hook de UserPromptSubmit que prende y apaga un archivo bandera. Mientras la bandera existe, cualquier pedido que cambie código va al playbook del tech lead sin tener que escribir /team:
{
  "hooks": {
    "UserPromptSubmit": [
      {
        "hooks": [
          {
            "type": "command",
            "command": "node \"${CLAUDE_PLUGIN_ROOT}/hooks/team-mode.js\"",
            "timeout": 5
          }
        ]
      }
    ]
  }
}
En la config se nota tu plan
El setup escribe .team/config.md. Estos son los valores por defecto:
tracker: ask          # ask | jira | notion | chat
dev_split: auto       # auto | fullstack | front-back
dev_model: sonnet     # inherit | opus | sonnet | haiku
dev_effort: high
qa_model: opus
qa_effort: medium     # with qa_model: sonnet, use high
max_fix_rounds: 3     # QA fail -> dev fix rounds before escalating to you
ui_url:               # local URL where the UI runs, used by QA for the visual check
ui_auth:              # Playwright storage state for pages behind login
pr: off               # on = after QA PASS, commit on team/<slug>, push and open the PR
Las dos decisiones que dependen de tu suscripción son dev_split y los modelos. En mi plan de $100 corro dos devs (front y back en paralelo) y Opus para los devs y para QA. En un plan de $20 dejaría dev_split: auto, que solo divide en trabajos grandes, y aceptaría que un solo dev tarde más. Ahí Sonnet es una buena opción para los devs, con la contra de que a veces necesita una ronda más de QA. A QA lo dejaría en el modelo más fuerte que puedas pagar. Es el rol cuyos errores te cuestan más, porque un bug que se escapa es justo lo que el equipo tenía que atrapar.
tracker puede apuntar a Jira o Notion a través de sus MCPs, o quedarse en el chat. Yo lo dejo en chat. pr lo dejo apagado porque quiero decidir yo cuándo se abre una PR. No gasta tokens de más en ningún caso, así que si tenés un despliegue con GitHub Actions al mergear, prenderlo es una automatización razonable.
Dimensionar antes de lanzar agentes
El tech lead lee lo justo del repo para entender el cambio, después lo clasifica y explica por qué en una línea:
| Tamaño | Cuándo | Quién trabaja |
|---|---|---|
| S | Un cambio chico, una sola capa | El tech lead solo, cero subagentes |
| M | Una feature real en una capa, o algo chico en las dos | Un dev más QA |
| L | Trabajo grande en front y back | Los dos devs en paralelo más QA |
El playbook cierra esa sección con "ante la duda, más chico: se puede escalar, los tokens no se devuelven". La mayoría de mis pedidos caen en M. Lanzar tres agentes para arreglar una línea es la forma más rápida de que un equipo de agentes parezca caro.
Briefs en disco en lugar de la conversación
Para trabajos M y L, el tech lead escribe .team/plan.md y un brief por tarea:
# T<n> - <title>          owner: dev-frontend | dev-backend
Goal: <one paragraph>
Files: <paths to touch / create; nothing else>
Contract: <API shapes shared with the other dev, if any>
UI URL: <frontend only: path of the page that shows the change>
Acceptance criteria:
- [ ] <observable, testable>
Run: <exact test/lint/build commands>
El prompt para despachar es una línea: implementá .team/tasks/T1.md, esta es la raíz del repo. El dev nunca ve la conversación. Como el tech lead ya encontró los archivos, el dev no vuelve a recorrer el repositorio para ver dónde trabajar, y de ahí sale la mayor parte del ahorro. Cada dev reporta en diez líneas o menos, así que el contexto del tech lead no crece con cada tarea.
El loop de QA y la salida de emergencia
QA lee el brief y el diff, corre los comandos del brief más los tests del área tocada y contrasta cada criterio de aceptación con evidencia. Un trabajo de frontend nunca es PASS solo por leer el código; necesita una captura. El reporte tiene una forma fija:
T<n>: PASS | FAIL
- [x]/[ ] <criterion>: <evidence>
Failures (if any): <file:line, what is wrong, how to reproduce>
Checks: <command: result>
Ante un FAIL, el tech lead le manda las fallas de QA textuales al mismo agente dev con SendMessage. Volver a lanzarlo tiraría el contexto del dev y lo obligaría a leer todo de nuevo. Cuando el dev responde, el mismo QA vuelve a verificar y corre todo otra vez, porque los arreglos rompen otras cosas.
Después de max_fix_rounds (tres por defecto) sin un PASS, el equipo frena y te pasa las fallas abiertas con una recomendación. Algunas fallas son problemas de la especificación, no del código, y ningún arreglo resuelve un brief que pidió lo que no era. Un loop de agentes sin salida es la forma más cara de no avanzar.
Capturas sin quemar tokens
El chequeo visual usa la CLI de Playwright con el Chrome que ya tenés instalado:
npx -y playwright screenshot --channel chrome --viewport-size "1280,800" \
  --load-storage .team/auth.json http://localhost:3000/products .team/qa/T1.png
Capturar cuesta cero tokens. Que QA lea una imagen de 1280x800 cuesta alrededor de 1,4k. Un MCP de navegador recorriendo el mismo flujo me costaba entre 5 y 20k por flujo, así que ahora queda solo como plan B cuando la CLI no llega. Para las páginas con login, guardás una sesión una vez:
npx playwright codegen --channel chrome --save-storage .team/auth.json http://localhost:3000
Con pr: on, el tech lead captura el estado "antes" previo a cualquier edición, y la última captura de PASS de QA es el "después". Las dos van al cuerpo de la PR con gh pr create --attach, que necesita GitHub CLI 2.99 o más nueva. La imagen que aprobó QA es la misma que termina en la PR, así que nada se captura dos veces.
Una corrida real y lo que costó
La prueba fue sobre mi propio CRM de WhatsApp, donde un agente de IA responde los chats entrantes y un operador puede tomar cualquier conversación. Una corrida anterior del equipo había sumado un panel de productos al CRM. Esa PR volvió con capturas de antes y después del panel, con productos y vacío. El requerimiento siguiente era que el chatbot realmente leyera esos productos.
El tech lead recorrió el repositorio, clasificó el trabajo como solo backend y despachó un dev más QA. El dev encontró tests que fallaban, los arregló, revisó su diff y entregó. QA lo aprobó en la primera ronda: una ronda de QA, cero rondas de arreglos.
Sobre el costo: antes de la tarea, mi uso de 5 horas en el plan de $100 estaba en 4%, y después en 10%. Eso es más o menos entre 1 y 2% del límite semanal. Si le pedís a Claude el desglose, te da los tokens del dev y los de QA por separado, más el descubrimiento que hizo la sesión principal con Haiku. En el plan de $20, mi estimación es que la misma tarea habría usado cerca del 30% de la ventana de 5 horas. Esa es la razón principal por la que existen los ajustes de modelo y de división.
Por qué no Agent Teams
Claude Code tiene un modo experimental, Agent Teams, donde cada compañero es una sesión completa que puede coordinarse con las demás. Es la mejor herramienta cuando los agentes de verdad necesitan hablar entre sí mientras trabajan. Por ejemplo, un front y un back negociando un contrato que todavía no está cerrado. Mi setup no puede hacer eso: el tech lead lleva el contrato, y si el contrato está mal, los dos devs construyen lo equivocado.
Para el trabajo de features que hago todos los días, los archivos de cada dev no se pisan y el contrato se puede escribir de entrada. Pagar sesiones completas compra una coordinación que no uso. Una advertencia práctica si corrés los dos: con CLAUDE_CODE_EXPERIMENTAL_AGENT_TEAMS=1, un subagente con nombre arranca como compañero, o sea como sesión completa, y deja de ser efímero. El modelo de costos de arriba solo vale con esa variable apagada.
Dónde todavía se rompe
- Si dos briefs tocan los mismos archivos, el tech lead tiene que usar worktrees y mergear antes de QA. Funciona, pero son más pasos y más tokens.
- Con
/teamen una sesión normal, el tech lead corre con el modelo que use la sesión. Para fijarlo en Opus con esfuerzo alto, arrancá la sesión conclaude --agent software-team:tech-lead. - Las PRs con imágenes solo funcionan en GitHub.com y Enterprise Cloud.
- QA no puede aprobar una UI a la que no llega. Sin
ui_url, sin un login guardado o sin navegador, el tech lead tiene que hacer el chequeo o pedirte una captura.
El objetivo del equipo nunca fue escribir más código por día. Claude ya hace eso. Era dejar de ser la única suite de tests del loop, y que "terminado" signifique algo que otro agente verificó con evidencia. Generar código se volvió barato. Probar que funciona es donde vive el costo que queda, y esa es la parte que vale la pena diseñar.
-Gonza
¿Querés un agente de IA como este trabajando para tu negocio? Conocé mi servicio de consultoría en IA.