 Gonzalo Gomez
Agente que reconoce productos y cotiza por WhatsApp
Agente que identifica productos desde una foto con Claude, busca el SKU en el catálogo y cotiza por WhatsApp y Messenger en 12 a 13 segundos, sin humanos.
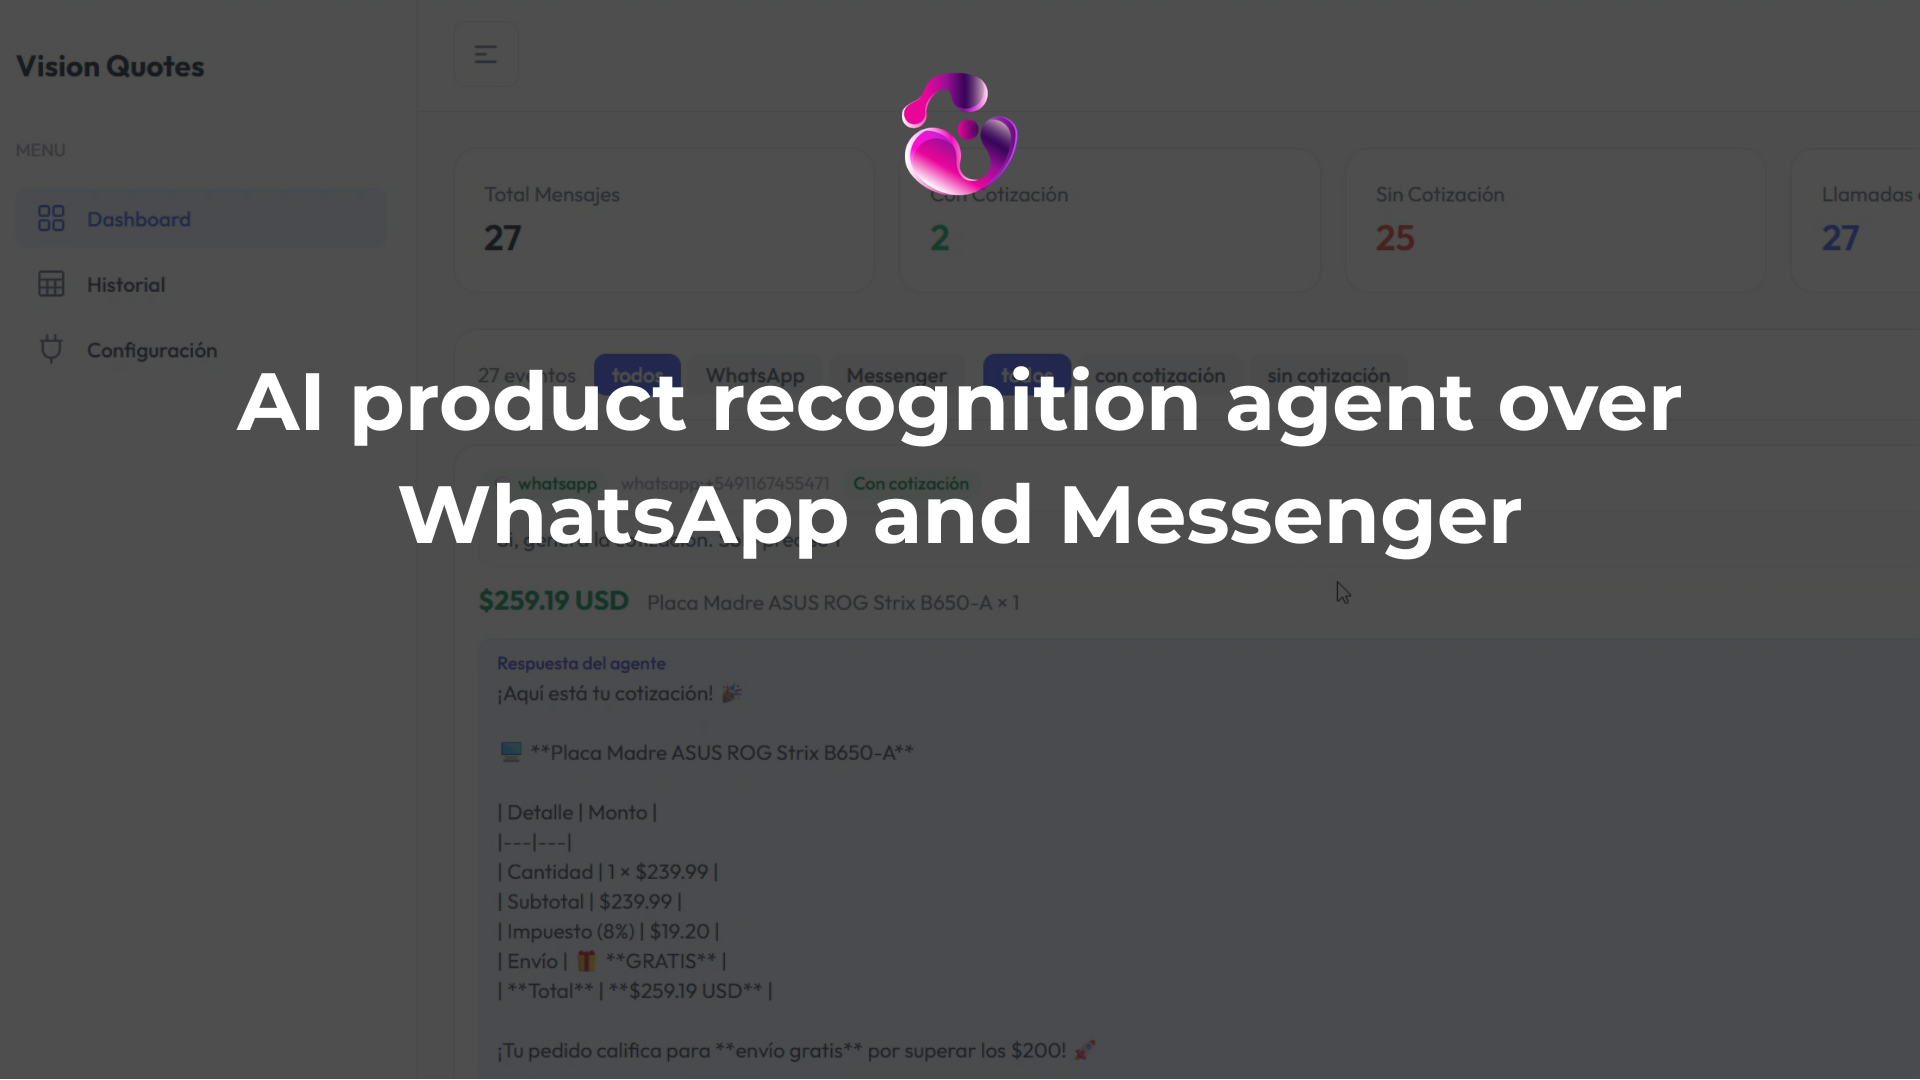
Un agente que reconoce productos y cotiza en tiempo real por WhatsApp y Messenger
El sistema funciona así: un cliente manda una foto de un motherboard por WhatsApp. El agente descarga la imagen, se la pasa a Claude y recibe un match estructurado del producto con score de confianza. Después chequea ese SKU contra el catálogo y responde con disponibilidad y cotización. Todo sin una persona en el medio. Podés ver el video del recorrido acá.
La latencia del ciclo completo, reconocer la imagen, buscar en el catálogo y generar la cotización, dio alrededor de 12 a 13 segundos en este build. Es medible y conviene saberlo antes de decidir si la arquitectura te sirve. Para mí es un buen tiempo, considerando que hacerlo a mano lleva varios minutos por cotización, y cada pedido suma al final del día.
La decisión de arquitectura que lo hace confiable
La decisión de diseño a la que siempre vuelvo es esta: Claude se ocupa de clasificar la imagen, no del precio. El agente identifica el producto y encuentra el SKU. El precio sale del catálogo, que es un JSON predefinido. La IA nunca calcula un precio.
Importa porque los LLM no son determinísticos. Si dejás que el modelo maneje la lógica de precios, en algún momento vas a tener un descuento alucinado, una moneda equivocada o un subtotal que no cierra. Mantener la IA en la capa de clasificación y la lógica de negocio en código determinístico es lo que hace seguro correr esto contra clientes reales.
Stack y puntos de entrada
El backend es Python con FastAPI. La visión y la generación de respuestas corren sobre Claude Sonnet 4.6 con el cliente de Anthropic. WhatsApp y Messenger pasan los dos por Twilio como capa de mensajería. El historial de conversación se persiste en SQLite, liviano para este caso y fácil de reemplazar después si necesitás algo más pesado.
Dos puntos de entrada alimentan un solo agent runner:
- El mensaje de WhatsApp entrante pega en
/webhook/whatsapp - El mensaje de Messenger entrante pega en
/webhook/messenger
Las dos rutas despachan al mismo agent runner como task async. La respuesta sale cuando el agente termina.
# Both channels dispatch to the same agent runner
async def handle_whatsapp(request: Request):
   payload = await request.json()
   sender = extract_sender(payload)
   text, image_url = extract_content(payload)
   asyncio.create_task(run_agent(channel=""whatsapp"", sender=sender, text=text, image_url=image_url))
   return Response(status_code=200)
Sumar un tercer canal, DMs de Instagram o hasta mail, es agregar una ruta nueva y una clave de canal nueva. El agent runner no cambia. Por eso el principio de responsabilidad única importa tanto cuando pensás en escalar tu app.
El loop del agente y por qué importa el tope
El agente tiene tres tools:
- analyze_product_image: le pasa los bytes de la imagen a Claude y devuelve un objeto estructurado con nombre de producto, categoría y score de confianza
- search_catalog: toma la descripción extraída del producto y consulta el catálogo JSON
- generate_quote: toma un SKU y una cantidad, y arma el detalle por ítem con las reglas de envío aplicadas
El loop del agente tiene un tope duro de cinco iteraciones. No es arbitrario. Sin eso, a veces vuelve a analizar una imagen que ya clasificó, o repite una búsqueda de catálogo que ya hizo. O retrocede porque no quedó confiado en un paso previo. Cinco iteraciones alcanzan para el happy path completo (analizar → buscar → cotizar) con lugar para un reintento si algo vuelve ambiguo.
MAX_ITERATIONS = 5
async def run_agent_loop(messages, tools, client):
   for i in range(MAX_ITERATIONS):
       response = await client.messages.create(
           model=""claude-sonnet-4-6"",
           tools=tools,
           messages=messages
       )
       if response.stop_reason == ""end_turn"":
           return response
       # process tool calls, append results, continue
   return response  # return whatever we have after max iterations
Si el loop llega al tope antes de terminar limpio, el agente devuelve lo que tiene. No se cuelga.
Contexto de la imagen entre turnos
Una de las sutilezas de este build: cuando un cliente manda una foto y después sigue hablando de ella sin reenviarla, el agente tiene que recordar qué imagen ya analizó.
El system prompt le dice explícitamente a Claude que no vuelva a llamar analyze_product_image si ya hay un producto analizado en el contexto. Importa porque la API de Messenger no vuelve a servir la URL original de la imagen en los turnos siguientes. Si el agente intenta traerla de nuevo, recibe un 404 y la llamada a la tool falla.
Esto se ve en el log de eventos del video: cuando el cliente pidió cotización del motherboard que había mandado antes, el agente intentó analyze_product_image. Recibió un error porque no había imagen en el mensaje actual, se recuperó desde el contexto y completó la cotización igual. El error es comportamiento esperado, no un bug: lo maneja el system prompt.
Por qué Claude para visión y no un modelo local
Entrenar un modelo local que reconozca de forma confiable todo lo que puede tener un catálogo es caro. Distintas categorías, distintas marcas, calidad de foto variable, ángulos, iluminación: son meses de trabajo y un costo de cómputo importante. Con la capacidad de visión de Claude tenés un modelo que ya entiende imágenes de producto en muchas categorías. Le pasás los bytes, recibís una clasificación estructurada y pagás por llamada.
El trade-off es que pagás costos de API en cada inferencia y dependés de un servicio externo. Para un catálogo con cientos de SKUs de electrónica, ese trade-off es el correcto.
El prompt de visión está separado del system prompt del agente. Le dice a Claude que actúa como motor de reconocimiento de productos, especifica exactamente la estructura JSON que tiene que devolver y hace obligatorio el esquema de salida. Claude suele seguir bien las instrucciones, pero hacer obligatorio el esquema importa. Si el modelo devuelve campos de más u omite uno requerido, la búsqueda en el catálogo se rompe de formas difíciles de debuggear.
VISION_PROMPT = """"""
You are a product recognition engine. Analyze the image and return a JSON object with this exact structure:
{
 ""product_name"": str,
 ""category"": str,
 ""brand"": str | null,
 ""confidence"": float,  # 0.0 to 1.0
 ""search_keywords"": [str]
}
Return only this object, no additional text.
""""""
El catálogo y por qué por ahora es JSON
El catálogo de productos es un archivo JSON estático con SKU, nombre, categoría, marca, precio, peso y los atributos extra que le sirvan a la tienda. Estático está bien para una demo y para un catálogo chico. También es una decisión de diseño: la forma del catálogo ya está definida como JSON. Cambiarlo por la respuesta de un CRM o una base externa es cambiar la fuente de datos, no el esquema.
La tool search_catalog hace matching por palabras clave contra ese archivo. Si escalás a miles de SKUs, vas a querer reemplazarlo por una búsqueda vectorial sobre embeddings de producto, pero la interfaz de la tool no cambia, solo su implementación interna.
La capa de observabilidad
El build incluye un dashboard de admin que transmite los eventos del agente en tiempo real por SSE. Cada llamada a una tool, sus entradas, sus salidas y la latencia total de la corrida se guardan como eventos en SQLite y se emiten a la UI.
Esto no es parte del agente. El agente es un módulo autocontenido, o sea que no sabe nada de la UI. El dashboard lee el log de eventos. Está para responder preguntas como: ¿por qué esta conversación no encontró match? ¿El análisis de imagen devolvió poca confianza? ¿La búsqueda en el catálogo devolvió cero resultados?
En la demo, el reconocimiento del motherboard volvió con 95% de confianza. Ese número está en el payload del evento. Si corrés esto en producción y ves que los matches bajan de cierto umbral, lo detectás en el log antes de que lo note un cliente.
Qué revisaría antes de ir a producción
La persistencia en SQLite funciona con una sola instancia. En el momento en que corrés más de un proceso, el historial se parte entre instancias y el agente pierde contexto en medio de la conversación. Reemplazalo por Postgres o Redis antes de escalar horizontal.
El tope de cinco iteraciones es el correcto para el set de tools actual. Si sumás más tools, como revisar historial de pedidos, aplicar un código de descuento o validar una promo, revisá ese número. Cinco iteraciones pueden quedar cortas, o volverse una fuente de salidas tempranas inesperadas.
La búsqueda sobre el JSON estático funciona pero no tiene fuzzy matching. Si un cliente manda la foto de un producto un poco fuera de las categorías esperadas, la confianza baja. Con una imagen de baja calidad pasa lo mismo, y las palabras clave pueden no encontrar nada. Sumar una búsqueda por similitud con embeddings sobre el catálogo recuperaría la mayoría de esos casos.
¿Te sirvió el artículo? Suscribite al newsletter o escribime directo con tus comentarios a gonzalo@ggomez.dev
-Gonza
Tags: computer-vision, twilio, claude-api, ai-agents, python
¿Querés un agente de IA así en tu WhatsApp? Mirá mis servicios de agentes de IA para WhatsApp.