 Gonzalo Gomez
Llamadas salientes con IA usando n8n, Twilio y ElevenLabs
Arquitectura de un asistente de llamadas salientes con IA en producción: n8n orquesta, Twilio llama, OpenAI razona y ElevenLabs habla. Con los trade-offs.
Introducción
Las llamadas salientes de ventas son uno de los canales más difíciles de automatizar con IA.
La latencia importa.
Los costos se acumulan rápido.
Las alucinaciones no se toleran.
Y los sistemas de voz fallan de forma ruidosa cuando algo se rompe.
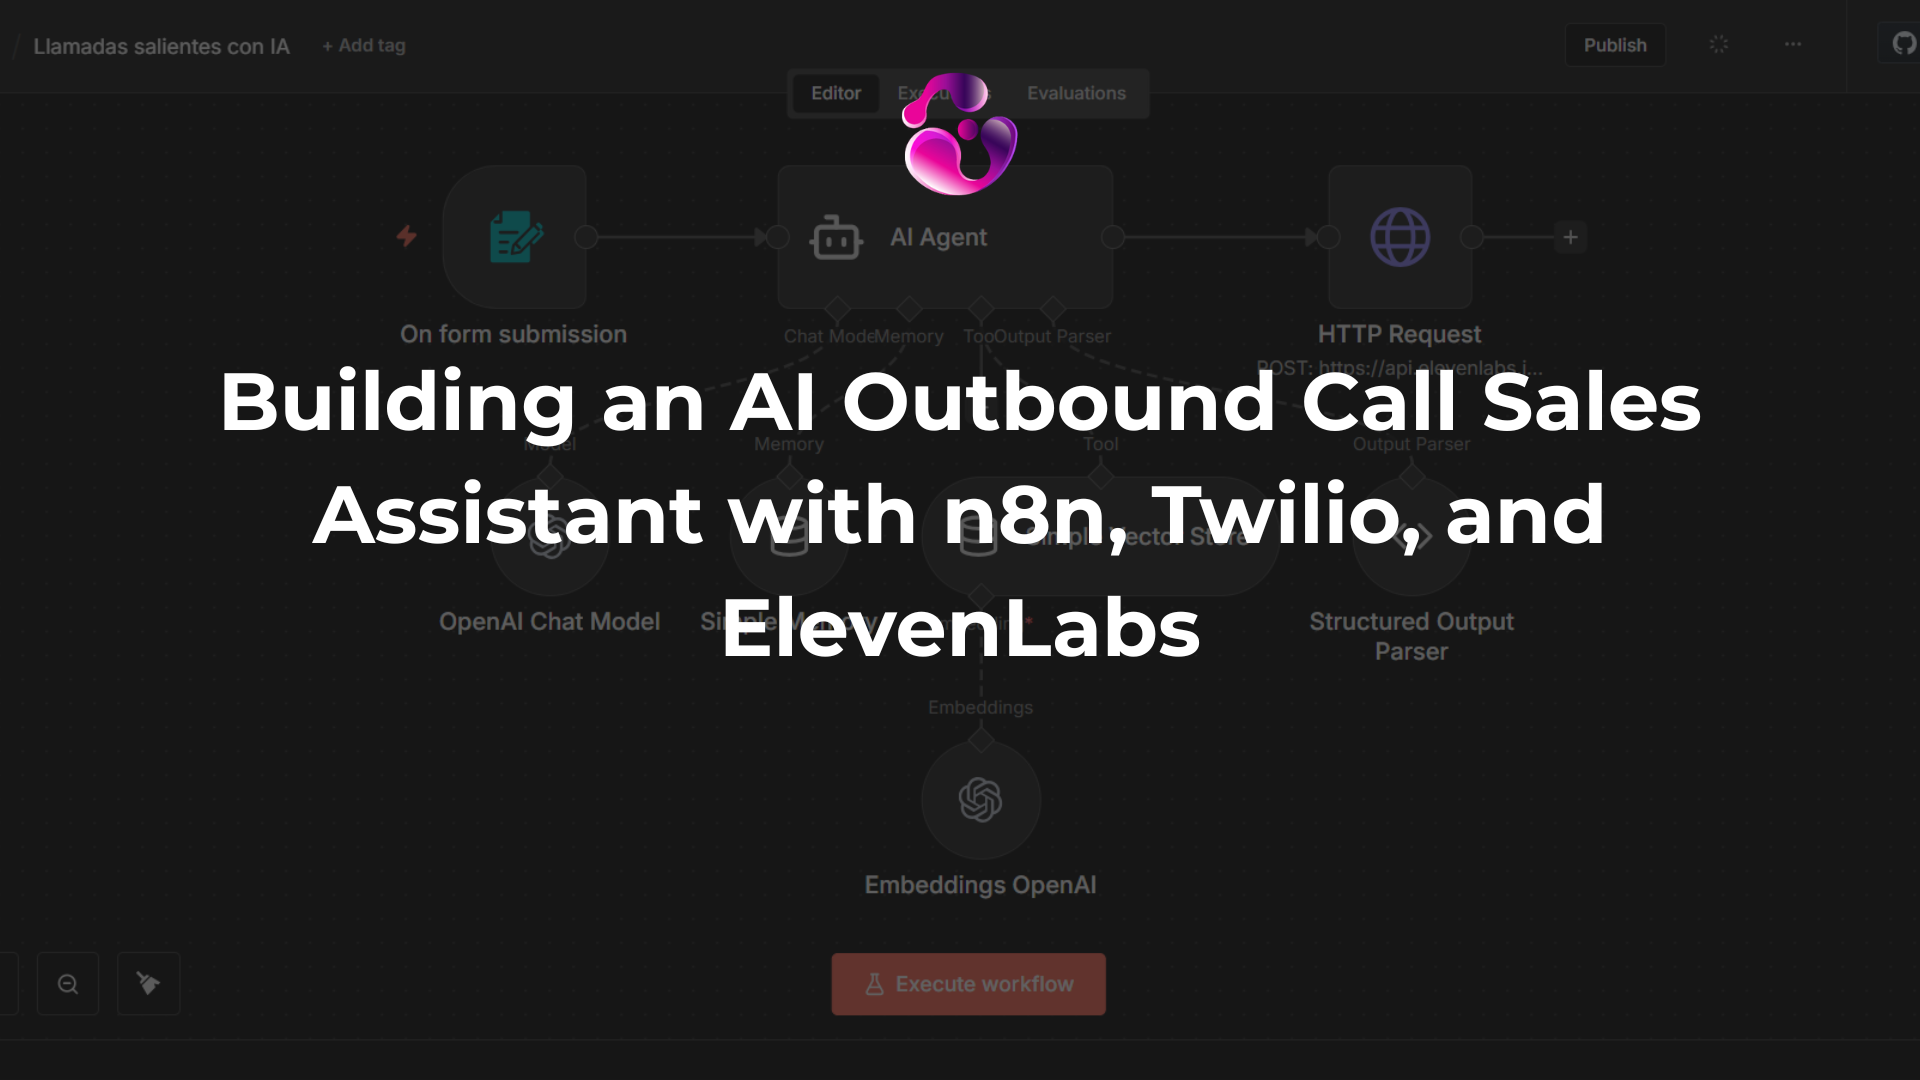
En este artículo desarmo un asistente de llamadas salientes con IA orientado a producción, construido con n8n, Twilio, OpenAI y ElevenLabs.
Esto no es una demo.
Es un sistema diseñado para llamadas reales, usuarios reales y restricciones reales.
Todos los ejemplos y las decisiones de arquitectura salen de la implementación que muestro en el video original.
Qué hace el sistema
A grandes rasgos, el sistema:
- Recibe un lead desde un formulario de contacto o una campaña
- Pre-califica intención y contexto con un agente de IA
- Consulta el inventario disponible con búsqueda vectorial
- Hace la llamada saliente de forma automática
- Lleva adelante una conversación de ventas natural en español
- Maneja objeciones, alternativas y seguimientos
- Registra y transcribe cada llamada para revisarla
Aclaro que esto no se trata de reemplazar al equipo de ventas. Se trata de filtrar, calificar y escalar el primer contacto sin quemar tiempo humano.
Panorama de la arquitectura
El sistema se apoya en una separación clara de responsabilidades.
1. n8n como capa de orquestación
n8n es la columna vertebral del sistema.
Se encarga de:
- Disparar workflows cuando se envía un formulario
- Pasar datos estructurados entre servicios
- Manejar la memoria y las tools del agente
- Forzar formatos de salida determinísticos
Esto es crítico. Los sistemas de voz se rompen cuando la orquestación es descuidada.
2. Twilio para la infraestructura telefónica
Twilio se encarga de:
- Provisionar los números de teléfono
- Ejecutar las llamadas salientes
- La confiabilidad a nivel carrier
Un aprendizaje clave de producción: la localidad del número importa.
Llamar a Argentina desde un número de Estados Unidos puede costar 30x más por minuto que usar un número local. Estas decisiones impactan directo en el margen y en la escalabilidad.
3. OpenAI para razonamiento y contexto
OpenAI se usa para:
- Interpretar el lead
- Extraer la intención
- Razonar sobre el inventario
Esto no es ChatGPT. Es uso por API, acotado y determinístico.
La temperatura se mantiene baja.
El uso de tokens está controlado.
El riesgo de alucinación se gestiona de forma explícita.
4. ElevenLabs para la voz y la conversación
ElevenLabs se encarga de:
- Speech-to-text
- Text-to-speech
- El flujo conversacional en tiempo real
- La selección de voz y el control de idioma
El agente de voz recibe:
- Nombre del lead
- Intención
- Inventario filtrado
- Mensaje de apertura pre-generado
Eso mantiene al agente de voz enfocado y predecible.
Por qué el inventario está vectorizado
En vez de consultar filas de una planilla, el inventario está vectorizado y se consulta semánticamente.
Eso habilita:
- Matching flexible cuando el producto exacto no está disponible
- Alternativas naturales sin lógica frágil
- Prompts más simples y menos ramificación condicional
Por ejemplo:
si no hay un Toyota Corolla, el agente puede sugerir un Yaris o un Etios sin reglas explícitas.
Es el patrón RAG clásico aplicado a ventas, no a chatbots.
Guardrails y contratos de salida
Una de las decisiones de producción más importantes es forzar la estructura de salida.
El agente de IA tiene que devolver:
- Nombre
- Teléfono
- Motivo de la llamada
- Mensaje de apertura
- Snapshot del inventario
Esa salida estructurada es la que alimenta al agente de voz.
Sin ese contrato:
- Las llamadas se vuelven inconsistentes
- Debuggear se vuelve doloroso
- Escalar se vuelve riesgoso
Costo, latencia y trade-offs de modelo
Este sistema es conservador a propósito.
Ejemplos:
- Modelos más chicos y baratos donde se puede
- Temperatura determinística
- Ventanas de memoria limitadas
- Presupuestos de tokens controlados
Un modelo más barato con menos latencia suele ser mejor que uno "más inteligente" que mete inestabilidad.
En voz, la previsibilidad le gana a la inteligencia.
Qué es y qué no es este sistema
Es:
- Una capa de preventa y calificación que escala
- Una forma de bajar la carga de trabajo humano
- Un sistema que respeta las restricciones de producción
No es:
- Un reemplazo para los closers
- Un vendedor mágico con IA
- Una solución sin mantenimiento
La IA de voz amplifica las malas decisiones más rápido que las buenas.
Para cerrar
Las llamadas salientes con IA no van de herramientas.
Van de arquitectura, restricciones y trade-offs.
Si lo tratás como una demo, va a fallar en producción.
Si lo diseñás como infraestructura, se convierte en palanca.
La implementación paso a paso está en mi video de YouTube. El código completo, con workflows y prompts, está en mi repo de GitHub.
¿Querés flujos así funcionando en tu negocio? Mirá mis servicios de automatización de procesos.